概述
什么是机器学习
从历史数据中自动分析获得规律(模型),并利用规律对未知数据进行预测。
为什么需要机器学习
解放生产力: 智能客服 解决专业问题: ET医疗 提供社会便利: 提供社会便利
机器学习的应用场景
方方面面
机器学习的工作流程
获取数据 -> 数据基本处理 -> 特征工程 -> 机器学习(模型训练) -> 模型评估。
评估符合要求,则上线服务。如果不符合要求,则重复上述步骤。
数据集的结构
机器学习的数据大部分数据存储到文件中。数据库中间件(mysql,nosql)等性能瓶颈,读取速度,格式不符合机器学习要求的数据格式。 numpy非常快,因为什么? 释放了GIL。
在数据集中: 一行数据成为一个样本。 一列数据称为一个特征。
可用的数据集
Kaggle: 大数据竞赛平台,80万科学家,真实数据,数据量巨大 https://www.kaggle.com/datasets
UCI: 收录了360个数据集。覆盖科学,生活经济等领域,数据量几十万 http://archive.ics.uci.edu/ml/index.php
scikit-learn: 数据量小,方便学习。https://scikit-learn.org/stable/,https://scikit-learn.org/stable/stable/datasets/index.html
常用数据集数据的结构组成
- 特征值+目标值(目标值是练习的和离散的)。特征? 比如分辨男女,一个人身高体重皮肤颜色,头发长度.都是特征值. 目标值:这个人是男是女,就是目标值。
- 只有特征值,没有目标值
数据分割
机器学习一般的数据集会划分为两个部分。
- 训练数据:用于训练,构建模型
- 测试数据:在数据检验时使用,用于评估模型是否有效、
划分比例:
- 训练集: 79% 80% 75%
- 测试集: 30%, 20% 25%
数据的特征工程
数据特征是什么
将原始数据转换为更好的代表预测模型的潜在问题的特征的过程,从而提高对未知数据的预测准确性。
使用专业背景知识和技巧处理数据,使得特征能在机器学习算法上发送更好的作用的过程。
-
特征提取: 将任意数据(文本或者图像)转换为可用于机器学习的数字特征。
-
特征预处理: 通过转化函数将特征数据转换成更加适合算法模型的特征数据过程。
- 归一化:为什么要进行归一化? 特征的单位或者大小相差较大,或者某特征的方法相比其他特征要大出几个数量级,容易影响(支配)目标结果,使得算法无法学习到其他的特征。
- 归一化的定义: 通过对原始数据进行变换,把数据映射到默认
[0,1]之间。 计算公式: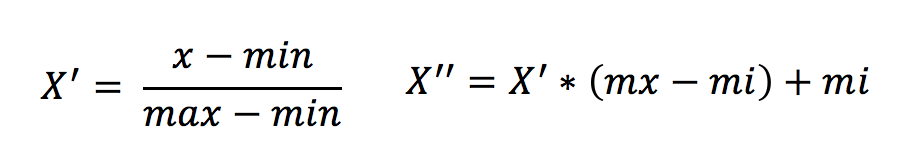
- 归一化的定义: 通过对原始数据进行变换,把数据映射到默认
- 标准化: 通过对原始数据进行把数据变换到均值为0,标准差为1的范围内。
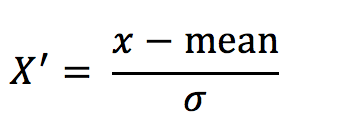 对于归一化来说:如果出现异常点,影响了最大值和最小值,那么结果显然会发生改变
对于标准化来说:如果出现异常点,由于具有一定数据量,少量的异常点对于平均值的影响并不大,从而方差改变较小。
- 归一化:为什么要进行归一化? 特征的单位或者大小相差较大,或者某特征的方法相比其他特征要大出几个数量级,容易影响(支配)目标结果,使得算法无法学习到其他的特征。
-
特征降维: 指在限定条件下,降低随机变量(特征)个数,得到一组”不相关”主变量的过程。 减少特征的数量,同时保留原来数据的大部分信息。可以通过PCA算法来是实现特征降维。
为什么要降维呢? 随着数据维度不断降低,数据存储所需的空间也会随之减少。低维数据有助于减少计算/训练用时。一些算法在高维度数据上容易表现不佳,降维可提高算法可用性。降维可以用删除冗余特征解决多重共线性问题。比如我们有两个变量:“一段时间内在跑步机上的耗时”和“卡路里消耗量”。这两个变量高度相关,在跑步机上花的时间越长,燃烧的卡路里自然就越多。因此,同时存储这两个数据意义不大,只需一个就够了。降维有助于数据可视化。如前所述,如果数据维度很高,可视化会变得相当困难,而绘制二维三维数据的图表非常简单。
特征工程的意义
直接影响预测结果。
特征抽取实例演示
特征抽取API
字典特征抽取类: sklearn.feature_extraction.DictVectorizer
作用: 对字典进行特征值化。
DictVectorizer(sparse=True,....)

# X: 字典或者包含字典的迭代器
# 返回值: 返回sparse矩阵
DictVectorizer.fit_transform(X):

# X: array数组或者sparse矩阵
# 返回值: 转换之前的数据格式
DictVectorizer.invers_transform(X)

# 返回类别名称
DictVectorizer.get_feature_names()

# 按照原先的标准转换
DictVectorizerr.transform(X)
使用流程
1.实例化类DictVectorizer 2.调用fit_transform方法进行特征抽取
字典数据提取的现象:
把字典中国的一些类别数据,分别进行转换特征数据。
文本特征抽取 Count
作用: 对文本数据进行特征值化
类: sklearn.feature_extraction.text.CountVectorizer
API
# 返回的是词频矩阵
CountVectorizer()

    # 统计所有文章中出现的词的位置标识,对应着列表中的单词(单个字母不统计,不支持中文,需要使用jieba分词),
    # X 文本或者包含文本字符串的可迭代对象
    # 返回值: 返回sparse矩阵
    CountVectorizer.fit_transform(X)

    # X: array数据或者sparse矩阵
    # 返回值:转换之前的数据格式
    CountVetorizer.inverse_transform(X)

    # 返回值: 单词列表
    CountVetorizer.get_feature_names()
文本特征抽取 tfidf
主要思想是: 如果某个词或短语在一篇文章中出现的概率高,b并且在其他文章中很少出现, 则认为该词或者短语具有很好的类别区分能力,适合用来分类。
TF-IDF的作用: 用以评估一字词对于一个文件集成一个语料库中的其中一份文件的重要程度。
tf(term frequency 词的频率)
idf(inverse document frequency 逆文档频率) log(总文档数据/该词出现的文档数量)
tf * idf 这个值称为重要性。
类 sklearn.feature_extraction.text.TfidfVectorizer
# 返回的是词频矩阵
CountVectorizer(stop_worlds=N)

    # 统计所有文章中出现的词的位置标识,对应着列表中的单词(单个字母不统计,不支持中文,需要使用jieba分词),
    # X 文本或者包含文本字符串的可迭代对象
    # 返回值: 返回sparse矩阵
    CountVectorizer.fit_transform(X)

    # X: array数据或者sparse矩阵
    # 返回值:转换之前的数据格式
    CountVetorizer.inverse_transform(X)

    # 返回值: 单词列表
    CountVetorizer.get_feature_names()
为什么需要这
分类机器学习算法的应用基础。
应用
- 文本分类
- 情感分析
数据的预处理
通过特定的统计方法(数学方法),将数据转换成算法要求的数据。
数据处理的方法
API: 在sklearn.preprocessing中。
-
数值型数据:
-
标准缩放
-
归一化:
通过对原始数据机型交换把数据映射到(默认[0,1])之间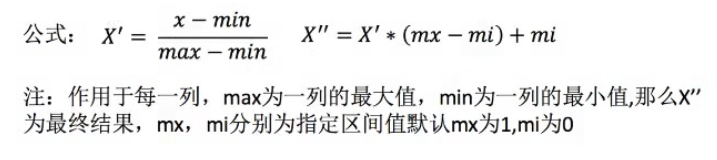
API: MinMaxScalar实现归一化的步骤:- 实例化
MinMaxScalar - 调用
fit_transform进行转换
mm = MinMaxScalar(feature_range=(2,3)) data = mm.fit_transform([[],[],[]]) print(data) - 实例化
-
标准化
通过对原始数据进行变换把数据变换到均值为0,标准差为1的范围内。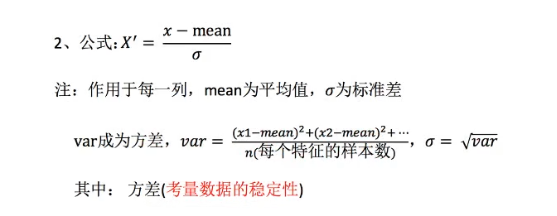 对于归一化来讲,如果出现了异常点,影响了最大值和最小值,那么结果显然会发生改变.
对标准化来讲,如果出现异常点,由于具有一定数据量,少量的异常点对平均值的影响并不大,从而方差改变较小。API: StandardScalar(....)标准化的步骤:- 实例化StandardScalar
- 调用fit_transfrom
#处理之后每列来说所有数据都聚集在均值0附近标准差差为1 StandardScalar(...) # X:numpy array格式的数据[n_samples,n_features] # 返回值: 转换后的形状相同的array StandardScalar.fit_transfrom(X) # 原始数据中每列特征的平均值 StandardScalar.mean_ # 原始数据每列特征的方差 StandardScalar.std_ -
缺失值 处理缺失值的方法:
- 删除
- 插补
插补使用的是:
Imputer方法# 完成缺失值插补 Imputer(miss_values='NaN',strategy='mean',axis=0) # X: numpy array格式的数据[n_samples,n_features] # 返回值: 转换后的形状相同的array Imputer.fit_transform(X) -
-
-
类别型数据
- one-hot编码
-
时间类型
- 时间的拆分
数据的降维
降维指的是降的是特征的维度(特征的数量)。 两种方式:特征选择 和 主成分分析
特征选择的原因
- 冗余: 部分特征的相关度高,容易消耗计算机性能
- 噪声: 部分特征会对结果产生影响
特征选择是什么?
就是单纯的从提取到的所有特征中选择部分特征作为训练集特征,特征在选择前后可以改变值,也可以不改变值。但是选择后的特征维数肯定比选择前小,毕竟我们只选择了其中一部分特征。
主要方法有:
- filter(过滤式): varianceThreshold
- Embedde(嵌入式): 正则化,决策树
- Wrapper(包裹式)
- 神经网络
API: sklearn.feature_selection.VarianceThreshold
# 删除所有低方差特征
VarianceThreshold(threhold=0.0)
    # X: numpy array格式的数据[n_samples,n_features]
    # 返回值: 训练集差异地域threshold的特征将被删除
    # 默认值是保留所有非零方差特征,即删除所有样本中具有相同值的特征
    Variance.fit_transform(X)
PCA 分析简化数据集的技术
目的是: 数据维度压缩,尽可能降低原数据的维度(复杂度),损失少量信息
作用: 可以削减回归分析或者聚类分析中特征的数量。
# 将数据分解为较低维数的空间
PCA(n_components=None)
    # X: numpy array格式的数据[n_samples,n_features]
    # 返回值: 转化后制定维度的array
    PCA.fit_transform(X)
机器学习算法基础
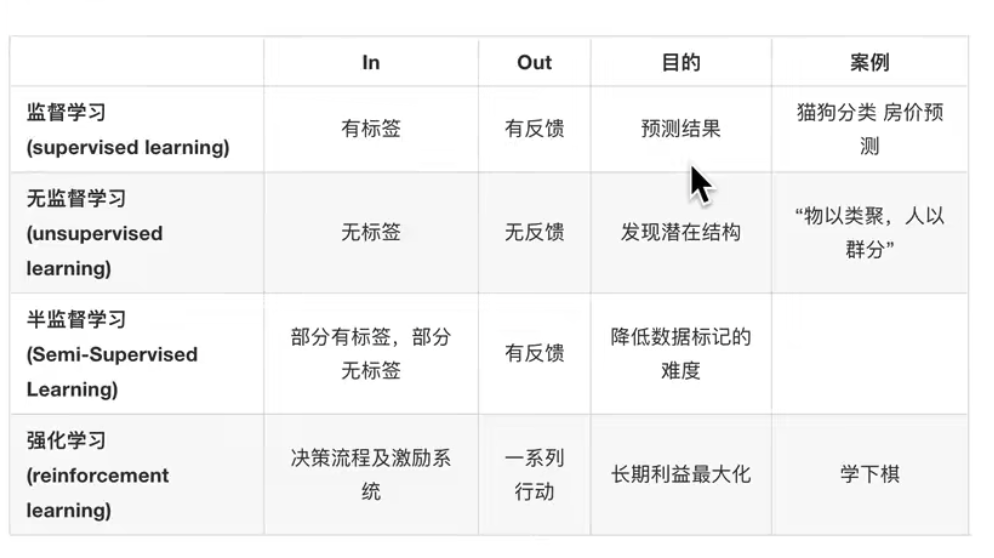
监督学习:supervised learnning
输入数据由输入特征值 和 目标值组成。
目标值连续则是回归问题, 目标值离散则是分类问题。
无监督学习. unsupervised learning
输入数据并未进行标记,没有目标值。 => 聚类(kmeans)
半监督学习: semi-supervised learning
训练集同时包含有标记样本数据 和 未标记样本数据
强化学习: reinforcement learning
本质是 make decisions 问题,即自动决策问题,并且可以做连续决策。
没有训练数据,建立模型的时候人为设定好可以操作的规则,不断自我尝试,自己去探索。
强化学习的目标就是获取更多的累计奖励。
举个例子:
小孩子想要走路,但是在这之前,他需要先站起来,站起来之后还要保持平衡,接下来就要先迈出一条腿,是左腿还是右腿,迈出一步还要迈出下一步。
小孩子就是agent,他试图通过 行动(即行走)来模型环境(行走的表面) 并且从一个状态转变到另一个状态(即他走的每一步),当他完成了任务的子任务(即走了几步)时,孩子收到奖励,并且当他不能走路时,就不会给奖励。
主要包含四个元素: agent 行动 环境 奖励
最后
期望和你一起遇见更好的自己