文档
es是面向文档的,文档是es中可搜索的最小单位,es的文档由一个或多个字段组成,类似于关系型数据库中的一行记录,但es的文档是以JSON进行序列化并保存的,每个JSON对象由一个或多个字段组成,字段类型可以是布尔,数值,字符串、二进制、日期等数据类型。
es每个文档都有唯一的id,这个id可以由我们自己指定,也可以由es自动生成。
es每一个文档,除了保存我们写入进行的文档原始数据外,也有文档自己的元数据,这些元数据,用于标识文档的相关信息。
{
  "_index" : "fxb_test",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 1,
  "_seq_no" : 0,
  "_primary_term" : 1,
  "found" : true,
  "_source" : {
    "username" : "fxb"
  }
}
从上面的文档中,我们可以看文档的元数据字段如下:
_index:文档所在索引名称
_source:原始json数据
_type:文档所属类型,es7.0以后只有为 _doc
_version:文档版本,如果对文档进行修改,则该字段会增加
_score:相关性打分
id:文档唯一id
索引
es索引,是es组织文档的方式,是拥有相结构文档的集合,可以把es的索引类比为关系型数据库的一张数据表。
索引是ES中非常重要的一种数据结构。后面我们会着重的学习其原理。
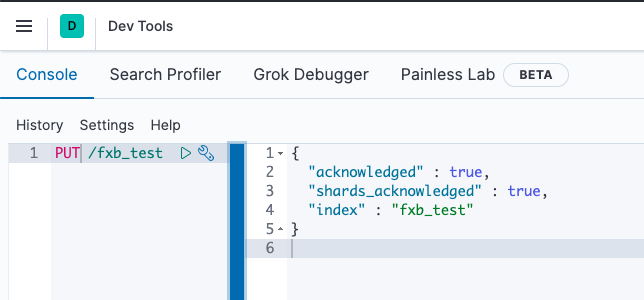
比如,我们想创建一个索引,可以在kibana使用下面的命令:
# 创建索引
PUT /fxb_test
右侧就会输出:
{
  "acknowledged" : true,
  "shards_acknowledged" : true,
  "index" : "fxb_test"
}
如图:
Mapping
Mapping 是对 索引的定义。 类似的MySQL中表结构定义, ES中支持手动定义Mapping , 动态映射这两种方式。
比如,我们上面创建的 fxb_test索引,就可以使用动态映射方式生成的Mapping。
# 添加一个文档到 fxb_test 索引中
POST /fxb_test/_create/1
{
  "username":"黄岛主",
  "age":57,
  "sex": "男"
}
输出结果:
{
  "_index" : "fxb_test",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 1,
  "result" : "created",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 0,
  "_primary_term" : 1
}
然后,我们看下自动映射出来的 Mapping
# 查看索引的Mapping
GET /fxb_test
输出结果:
{
  "fxb_test" : {
    "mappings" : {
      "properties" : {
        "age" : {
          "type" : "long"
        },
        "sex" : {
          "type" : "text",
          "fields" : {
            "keyword" : {
              "type" : "keyword",
              "ignore_above" : 256
            }
          }
        },
        "username" : {
          "type" : "text",
          "fields" : {
            "keyword" : {
              "type" : "keyword",
              "ignore_above" : 256
            }
          }
        }
      }
    }
  }
}
这里就先简单了解一下,相关的命令。 至于上面每个字段的含义以及作用,我们后面详细介绍。
集群
ES的集群搭建很简单,不需要依赖第三方协调管理组件,自身内部就实现了集群的管理功能。ES集群由一个或多个Elasticsearch节点组成,每个节点配置相同的 cluster.name 即可加入集群,默认值为 “elasticsearch”。确保不同的环境中使用不同的集群名称,否则最终会导致节点加入错误的集群。
一个Elasticsearch服务启动实例就是一个节点(Node)。节点通过 node.name来设置节点名称,如果不设置则在启动时给节点分配一个随机通用唯一标识符作为名称。
分片
ES支持PB级全文搜索,当索引上的数据量太大的时候,ES通过水平拆分的方式将一个索引上的数据拆分出来分配到不同的数据块上,拆分出来的数据库块称之为一个分片。
这类似于MySQL的分库分表,只不过MySQL分库分表需要借助第三方组件而ES内部自身实现了此功能。
在一个多分片的索引中写入数据时,通过路由来确定具体写入哪一个分片中,所以在创建索引的时候需要指定分片的数量,并且分片的数量一旦确定就不能修改。
分片的数量和下面介绍的副本数量都是可以通过创建索引时的settings来配置,ES默认为一个索引创建1个主分片(ES 7.x), 并分别为每个分片创建一个副本。
ES通过分片的功能使得索引在规模上和性能上都得到提升,每个分片都是Lucene中的一个索引文件,每个分片必须有一个主分片和零到多个副本。
# 创建2个副本,5个分片的索引
PUT /fxb_test2
{
  "settings": {
    "number_of_replicas": 2,
    "number_of_shards": 5
  }
}
返回结果:
{
  "acknowledged" : true,
  "shards_acknowledged" : true,
  "index" : "fxb_test2"
}
副本
副本就是对分片的Copy,每个主分片都有一个或多个副本分片,当主分片异常时,副本可以提供数据的查询等操作。主分片和对应的副本分片是不会在同一个节点上的,所以副本分片数的最大值是 n-1(其中n为节点数)。
对文档的新建、索引和删除请求都是写操作,必须在主分片上面完成之后才能被复制到相关的副本分片,ES为了提高写入的能力这个过程是并发写的,同时为了解决并发写的过程中数据冲突的问题,ES通过乐观锁的方式控制,每个文档都有一个 _version (版本)号,当文档被修改时版本号递增。一旦所有的副本分片都报告写成功才会向协调节点报告成功,协调节点向客户端报告成功。
关于,ES 的基本概念,就介绍到这里。
下一篇: 《ES索引管理》
最后
期望与你一起遇见更好的自己