一文搞懂内存溢出,保内存平安,防止你被祭天:[手动滑稽]:
释义
OOM的含义,到底是什么意思?
是JVM独有的吗? linux是否也会存在,那又是怎么肥事?
OOM : Out Of Memory . 内存溢出。内存溢出来了,也就是说内存不够用了,就会发生这个问题了。
内存又是什么呢?
1、 内存 是计算机的重要部件之一。它用于暂时存放CPU中的运算数据,与硬盘等外部存储交换数据。是外存与CPU进行沟通的桥梁。
2、Java内存。说到这里我们就不得说一下java的内存模型(JMM)了。如下图。
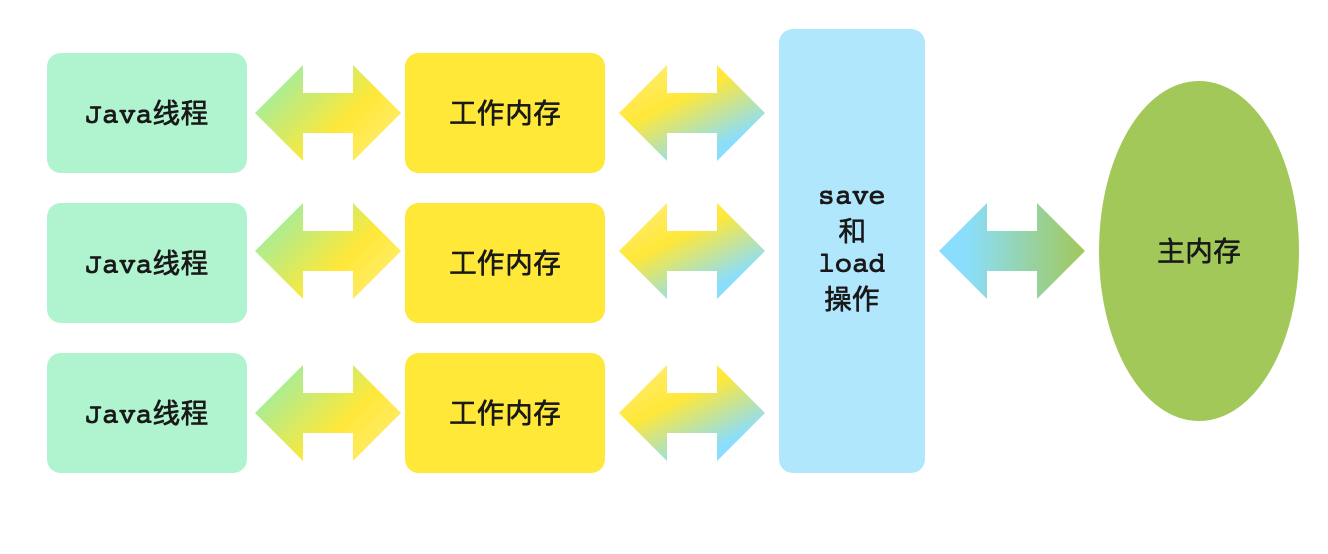
就这个一个图就很不下几十个面试考点:比如votitle关键字,内存栅栏,指令重排,5项Happen-Before原则,内存原子操作,数据IO操作等等。
闲话少扯,抛个问题,OOM发生区域会上图中那个部分发生呢?
前言
java运行时内存区域 JAVA RUNTIME MEMEORY AREA, 注意区分JMM.
大家都知道的,java 运行时内存区域,分为程序计数器(PC寄存器),java虚拟机栈,本地方法栈,堆,方法区,运行时常量池,堆外内存(直接内存)
1、程序计数器是一块较小的内存空间,是当前线程正在执行的那条字节码指令的地址。若当前线程正在执行的是一个本地方法,那么此时程序计数器为Undefined。
2、Java 虚拟机栈是描述 Java 方法运行过程的内存模型。Java 虚拟机栈会为每一个即将运行的 Java 方法创建一块叫做“栈帧”的区域,用于存放该方法运行过程中的一些信息,比如:局部变量表,操作数栈,动态链接,方法出口信息等,方法执行的过程即为栈帧压栈出栈的过程。
3、本地方法栈是为 JVM 运行 Native 方法准备的空间,由于很多 Native 方法都是用 C 语言实现的,所以它通常又叫 C 栈。它与 Java 虚拟机栈实现的功能类似,只不过本地方法栈是描述本地方法运行过程的内存模型。
4、堆是用来存放对象的内存空间,几乎所有的对象都存储在堆中。这一区域是线程共享,整个 Java 虚拟机只有一个堆,所有的线程都访问同一个堆。堆又可划分为年轻代和老年代,年轻代内存又可以分为Eden, from Surivor,to Surivor,并且默认以8:1:1的比例进行分配。
5、方法区:Java 虚拟机规范中定义方法区是堆的一个逻辑部分。方法区存放以下信息:已经被虚拟机加载的类信息,常亮,静态变量,即时编译编译器编译后的代码。线程共享的区域。为了与堆区分,方法还有一个别名:Non-Heap(非堆)。
5.1 、运行时常量池: 存放常量的区域。 在运行期间,可以向常量池中添加新的变量,如 String 类的intern()方法。
6、堆外内存是java虚拟机之外的内容,但也可能被java使用。需要注意的是,这部分内容也会因内存不足而抛出 OutOfMemoryError、
知道了Java运行内存区域,那么可能发生 OOM的区域有哪些呢?
我们都知道OOM只的是内存溢出,所以 堆,非堆即方法区,本地方法栈,以及堆外内存 都是会发生 OOM 的。
那java虚拟机栈呢? 不会发生内容溢出吗? 会! 但是 栈发生内容溢出的时候,报的错误是 StackOverflowError.
那程序计数器呢? 程序计数器,是不会发送内容溢出的。 因为 存储的是:当前线程正在执行的那条字节码指令的地址啊。
如下图:
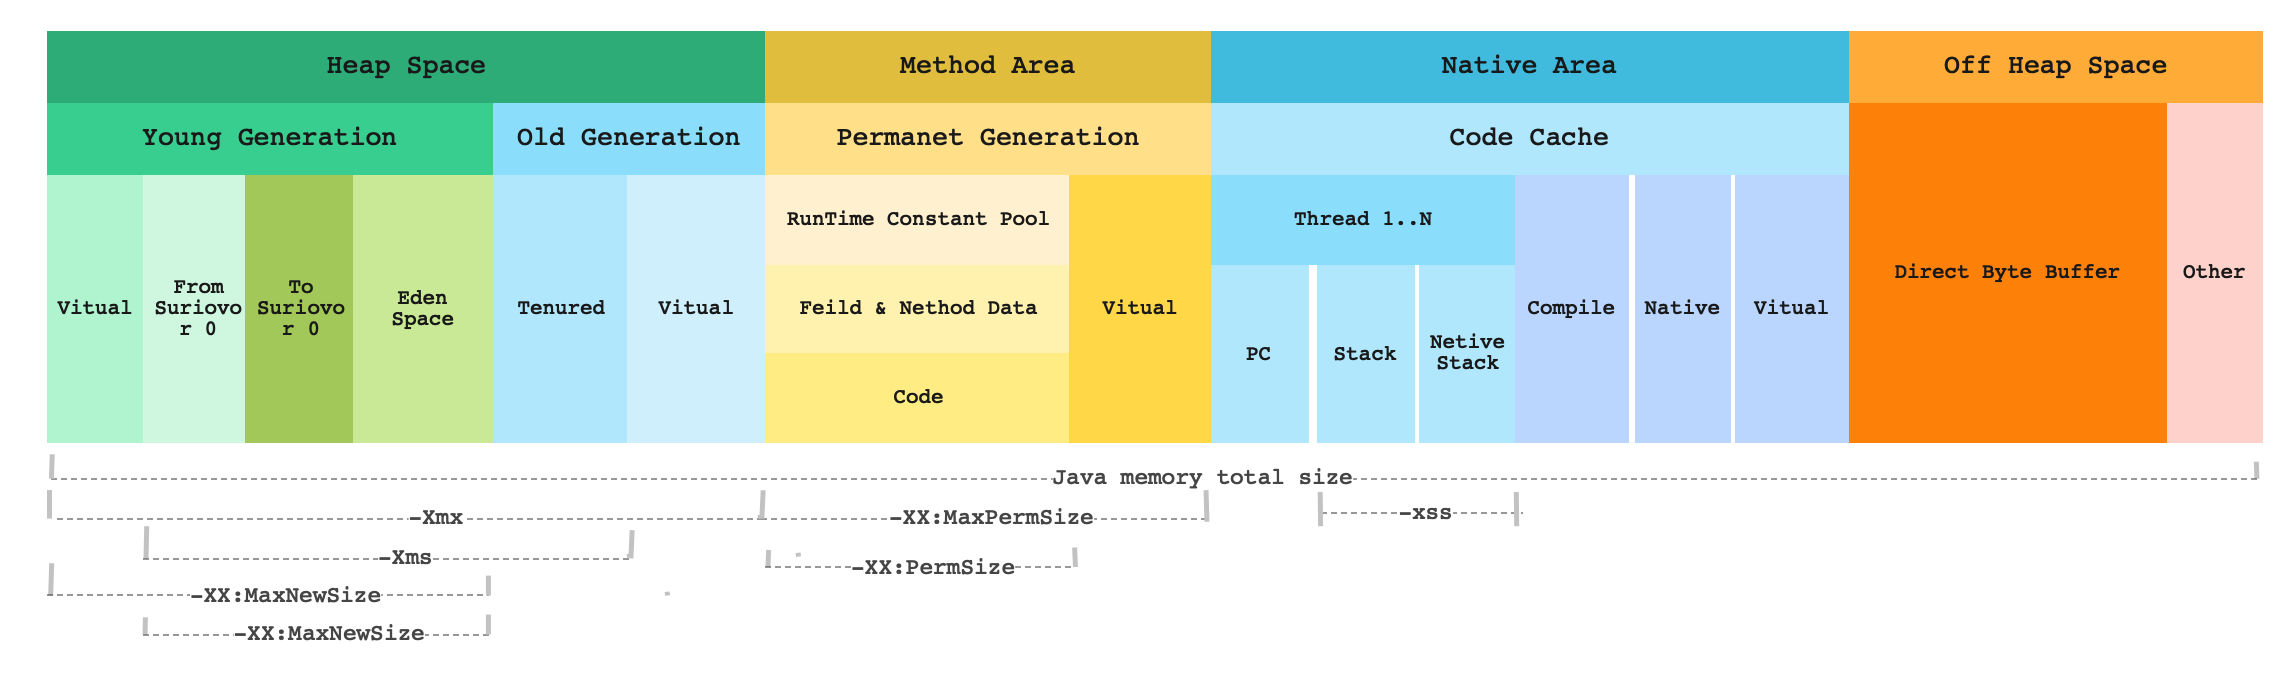
在上图中还指定了各区域大小的参数配置:
-
-Xms设置堆的最小空间大小。 -
-Xmx设置堆的最大空间大小。 -
-XX:NewSize设置新生代最小空间大小。 -
-XX:MaxNewSize设置新生代最大空间大小。 -
-XX:PermSize设置永久代最小空间大小。 -
-XX:MaxPermSize设置永久代最大空间大小。 -
-Xss设置每个线程的堆栈大小。
没有直接设置老年代的参数,但是可以设置堆空间大小和新生代空间大小两个参数来间接控制。 老年代空间大小=堆空间大小-年轻代大空间大小
场景分析
我们挨个分析下发生OOM的9种场景
什么时候会发生OOM 呢? 当内存严重不够用的时候就会发生 java.lang.OutOfMemoryError 。
我们来看下每个区域都有可能出现内存溢出问题.
JavaHeap space
当堆内存(Heap Space)没有足够空间存放新创建的对象时,就会抛出 java.lang.OutOfMemoryError:Javaheap space 错误。
Javaheap space 错误产生的常见原因可以分为以下几类:
1.请求创建一个超大对象,通常是一个大数组。
2.超出预期的访问量/数据量,通常是上游系统请求流量飙升,常见于各类促销/秒杀活动,可以结合业务流量指标排查是否有尖状峰值。
3.过度使用终结器(Finalizer),该对象没有立即被 GC。
4.内存泄漏(Memory Leak),大量对象引用没有释放,JVM 无法对其自动回收,常见于使用了 File 等资源没有回收。
解决方案
针对大部分情况,通常只需要通过 -Xmx 参数调高 JVM 堆内存空间即可。如果仍然没有解决,可以参考以下情况做进一步处理:
1、如果是超大对象,可以检查其合理性,比如是否一次性查询了数据库全部结果,而没有做结果数限制。 2、如果是业务峰值压力,可以考虑添加机器资源,或者做限流降级。 3、如果是内存泄漏,需要找到持有的对象,修改代码设计,比如关闭没有释放的连接。
代码案例
/**
 * 演示大对象
 * -Xms128M -Xmx128M
 */
public static void bigObject() {
    // 21 可以,22就会OOM
    // 4* 1024 * 1024 = 4M * 32 = 128M
    int[] integers = new int[1024*1024*32];
}
报错内容
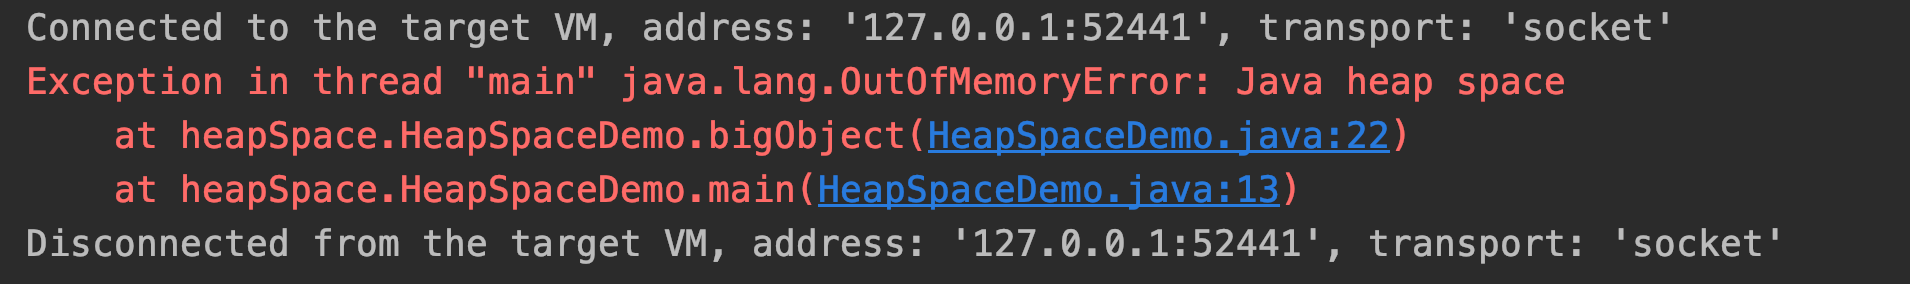
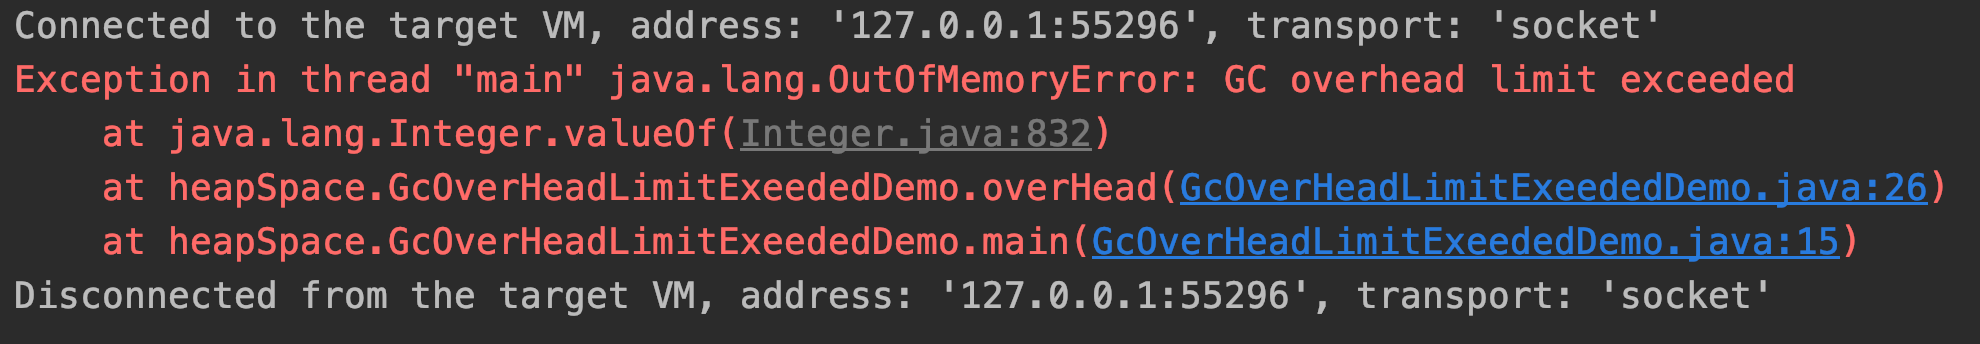
GC overhead limit exceeded
当 Java 进程花费 98% 以上的时间执行 GC,但只恢复了不到 2% 的内存,且该动作连续重复了 5 次,就会抛出 java.lang.OutOfMemoryError:GC overhead limit exceeded 错误。简单地说,就是应用程序已经基本耗尽了所有可用内存, GC 也无法回收。
解决方案
同 JavaHeap space 部分的异常解决方案。
/**
 * 演示 频繁GC
 * -Xms128M -Xmx128M
 */
public static void overHead() {
    Map map = new HashMap();
    Random r = new Random();
    while (true) {
        map.put(r.nextInt(), "value");
    }
}
报错内容:
Permgen space(JDK8 已废弃, see 元空间。)
:::info
为什么会废弃 永久代? see: http://openjdk.java.net/jeps/122
:::
该错误表示永久代(Permanent Generation)已用满,通常是因为加载的 class 数目太多或体积太大。
永久代存储对象主要包括以下几类:
加载/缓存到内存中的 class 定义,包括类的名称,字段,方法和字节码;
常量池;
对象数组/类型数组所关联的 class;
JIT 编译器优化后的 class 信息。
PermGen 的使用量与加载到内存的 class 的数量/大小正相关。
解决方案
根据 Permgen space 报错的时机,可以采用不同的解决方案,如下所示:
- 程序启动报错,修改
-XX:MaxPermSize启动参数,调大永久代空间。 - 应用重新部署时报错,很可能是没有应用没有重启,导致加载了多份
class信息,只需重启 JVM 即可解决。 - 运行时报错,应用程序可能会动态创建大量
class,而这些class的生命周期很短暂,但是 JVM 默认不会卸载class,可以设置-XX:+CMSClassUnloadingEnabled和-XX:+UseConcMarkSweepGC这两个参数允许JVM卸载class。 - 如果上述方法无法解决,可以通过
jmap命令dump内存对象jmap-dump:format=b,file=dump.hprof,然后利用Eclipse MAT https://www.eclipse.org/mat功能逐一分析开销最大的classloader和重复class。
Metaspace
JDK 1.8 使用 Metaspace 替换了永久代(Permanent Generation)
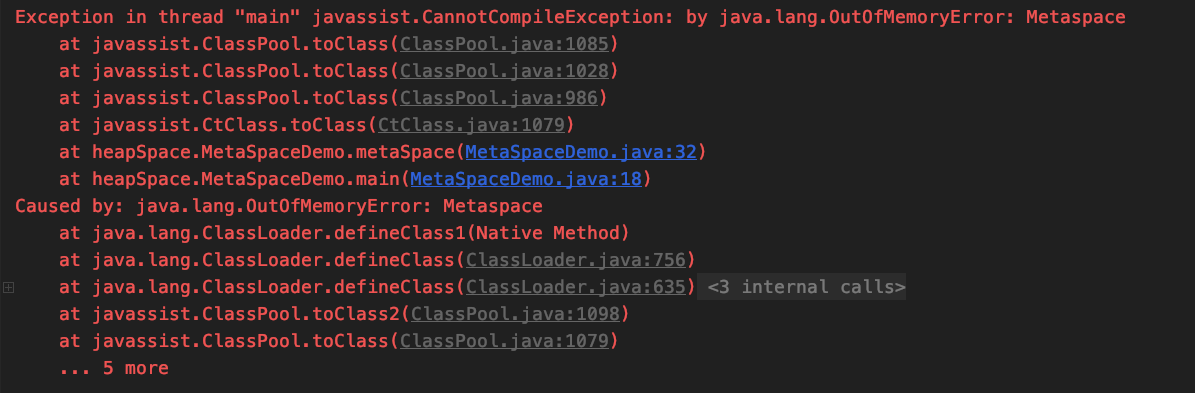
该错误表示 Metaspace 已被用满,通常是因为加载的 class 数目太多或体积太大。
此类问题的原因与解决方法跟 PermGenspace 非常类似,可以参考上文。
需要特别注意的是调整 Metaspace 空间大小的启动参数为 -XX:MaxMetaspaceSize。
代码案例
/**
 * 演示  元数据区
 * <p>
 * 在 `for` 循环中, 动态生成很多class, 最终将这些class加载到 Metaspace 中
 *
 * 注意配置: -XX:MaxMetaspaceSize=64m
 *
 * @throws Exception
 */
public static void metaSpace() throws Exception {
    for (int i = 0; ; i++) {
        Class c = cp.makeClass("eu.plumbr.demo.Generated" + i).toClass();
        System.out.println(i);
    }
}
报错内容:
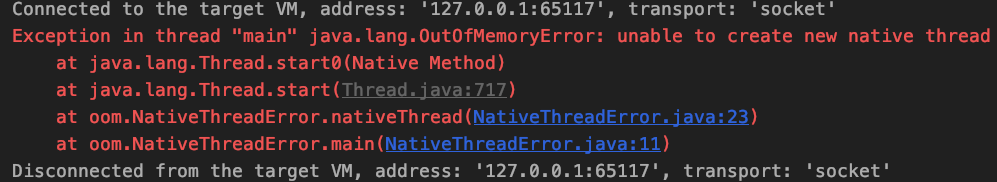
Unable to create new native thread
每个 Java 线程都需要占用一定的内存空间,当 JVM 向底层操作系统请求创建一个新的 native 线程时,如果没有足够的资源分配就会报此类错误。
原因分析
JVM 向 OS 请求创建 native 线程失败,就会抛出 Unable to create new native thread,常见的原因包括以下几类:
线程数超过操作系统最大线程数 ulimit 限制;
线程数超过 kernel.pid_max(只能重启);
native 内存不足;
该问题发生的常见过程主要包括以下几步:
JVM 内部的应用程序请求创建一个新的 Java 线程;
JVM native 方法代理了该次请求,并向操作系统请求创建一个 native 线程;
操作系统尝试创建一个新的 native 线程,并为其分配内存;
如果操作系统的虚拟内存已耗尽,或是受到 32 位进程的地址空间限制,操作系统就会拒绝本次 native 内存分配;
JVM 将抛出 java.lang.OutOfMemoryError:Unableto createnewnativethread 错误。
解决方案
- 升级配置,为机器提供更多的内存;
- 降低
Java Heap Space大小; - 修复应用程序的线程泄漏问题;
- 限制线程池大小;
- 使用
-Xss参数减少线程栈的大小; - 调高
OS层面的线程最大数:执行ulimit -a查看最大线程数限制,使用ulimit -u xxx调整最大线程数限制。
代码案例
/**
 * 演示: Unable to create new native thread
 */
private static void nativeThread() {

    while (true) {
        new Thread(new Runnable() {
            public void run() {
                try {
                    Thread.sleep(10000000);
                } catch (InterruptedException e) {
                }
            }
        }).start();
    }
}
报错内容:
Out of swap space
该错误表示所有可用的虚拟内存已被耗尽。虚拟内存(Virtual Memory)由物理内存(Physical Memory)和交换空间(Swap Space)两部分组成。当运行时程序请求的虚拟内存溢出时就会报 Outof swap space 错误。
这个错误通常是操作系统层面的原因。
原因分析
该错误出现的常见原因包括以下几类:
-
- 地址空间不足;
- 2.物理内存已耗光;
- 3.应用程序的本地内存泄漏(
native leak),例如不断申请本地内存,却不释放。 - 4.执行
jmap-histo:live命令,强制执行Full GC;如果几次执行后内存明显下降,则基本确认为Direct ByteBuffer问题。
解决方案
根据错误原因可以采取如下解决方案:
-
- 升级地址空间为
64 bit;
- 升级地址空间为
-
- 使用
Arthas检查是否为Inflater/Deflater解压缩问题,如果是,则显式调用end方法。
- 使用
-
Direct ByteBuffer问题可以通过启动参数-XX:MaxDirectMemorySize调低阈值。
-
- 升级服务器配置/隔离部署,避免争用。
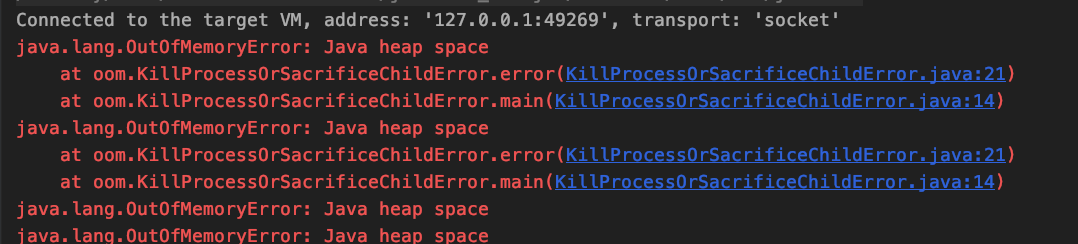
Kill process or sacrifice child
有一种内核作业(Kernel Job)名为 Out of Memory Killer,它会在可用内存极低的情况下“杀死”(kill)某些进程。OOM Killer 会对所有进程进行打分,然后将评分较低的进程“杀死”,具体的评分规则可以参考 Surviving the Linux OOM Killer。
不同于其他的 OOM 错误, Killprocessorsacrifice child错误不是由 JVM 层面触发的,而是由操作系统层面触发的。
原因分析
默认情况下,Linux 内核允许进程申请的内存总量大于系统可用内存,通过这种“错峰复用”的方式可以更有效的利用系统资源。
然而,这种方式也会无可避免地带来一定的“超卖”风险。例如某些进程持续占用系统内存,然后导致其他进程没有可用内存。此时,系统将自动激活 OOM Killer,寻找评分低的进程,并将其“杀死”,释放内存资源。
解决方案
- 升级服务器配置/隔离部署,避免争用。
OOM Killer调优。
代码案例
/**
 * 演示:Kill process or sacrifice child
 */
private static void error() {
    java.util.List<int[]> l = new java.util.ArrayList();
    for (int i = 10000; i < 100000; i++) {
        try {
            l.add(new int[100000000]);
        } catch (Throwable t) {
            t.printStackTrace();
        }
    }
}
报错内容
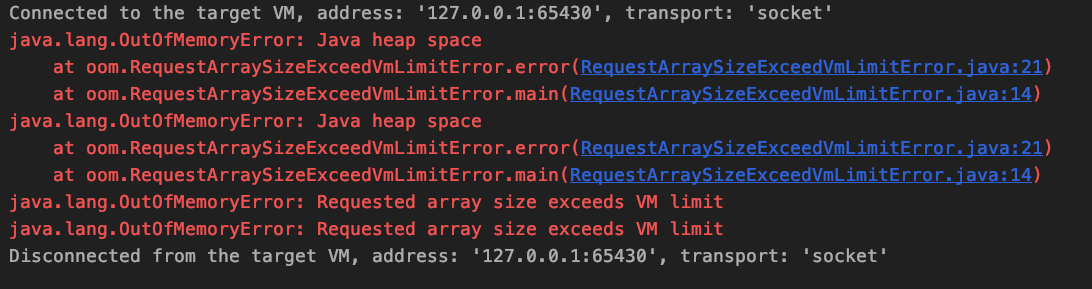
Requested array size exceeds VM limit
JVM 限制了数组的最大长度,该错误表示程序请求创建的数组超过最大长度限制。
JVM 在为数组分配内存前,会检查要分配的数据结构在系统中是否可寻址,通常为 Integer.MAX_VALUE-2。
此类问题比较罕见,通常需要检查代码,确认业务是否需要创建如此大的数组,是否可以拆分为多个块,分批执行。
private static void error() {
    for (int i = 3; i >= 0; i--) {
        try {
            int[] arr = new int[Integer.MAX_VALUE-i];
            System.out.format("Successfully initialized an array with %,d elements.\n", Integer.MAX_VALUE-i);
        } catch (Throwable t) {
            t.printStackTrace();
        }
    }
}
报错内容
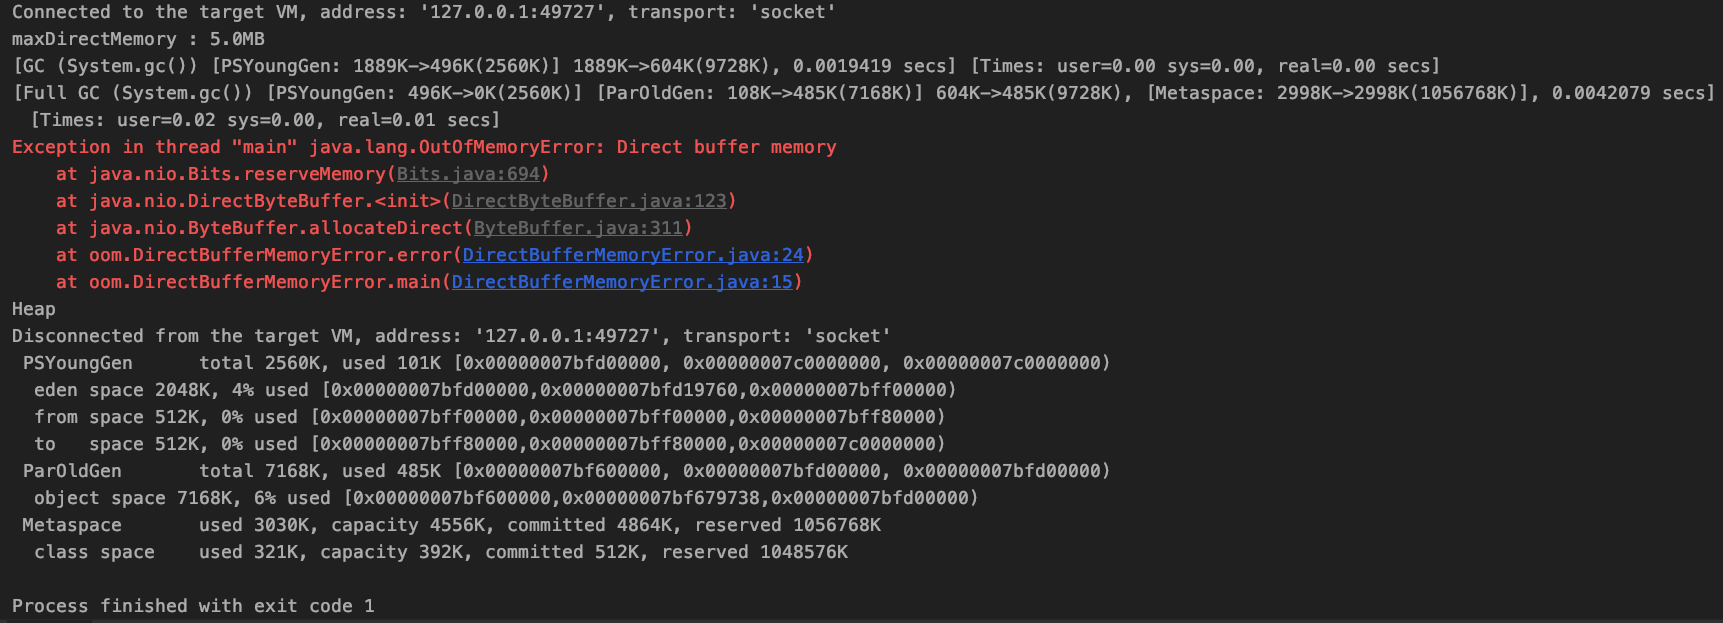
Direct buffer memory
java 允许应用程序通过 Direct ByteBuffer 直接访问堆外内存,许多高性能程序通过 Direct ByteBuffer 结合内存映射文件(Memory Mapped File)实现高速 IO。
原因分析
Direct ByteBuffer 的默认大小为 64 MB,一旦使用超出限制,就会抛出 Directbuffer memory 错误。
解决方案
Java只能通过ByteBuffer.allocateDirect方法使用Direct ByteBuffer,因此,可以通过Arthas等在线诊断工具拦截该方法进行排查。- 检查是否直接或间接使用了
NIO,如netty,jetty等。 - 通过启动参数
-XX:MaxDirectMemorySize调整Direct ByteBuffer的上限值。 - 检查
JVM参数是否有-XX:+DisableExplicitGC选项,如果有就去掉,因为该参数会使System.gc()失效。 - 检查堆外内存使用代码,确认是否存在内存泄漏;或者通过反射调用
sun.misc.Cleaner的clean()方法来主动释放被Direct ByteBuffer持有的内存空间。 - 内存容量确实不足,升级配置。
代码案例
/**
 * 演示对外内存溢出
 * -Xms10m -Xmx10m -XX:+PrintGCDetails -XX:MaxDirectMemorySize=5m
 */
private static void error() {
    System.out.println("maxDirectMemory : " + (sun.misc.VM.maxDirectMemory() / (double) (1024 * 1024)) + "MB");
    ByteBuffer byteBuffer = ByteBuffer.allocateDirect(6 * 1024 * 1024);
    System.out.println(byteBuffer);
}
报错内容
排查思路
分享遇到OOM类问题如何快速定位问题,具体哪行代码发生了问题
什么表现会发生OOM呢?
最直接的~,有报错,outOfMemoryError。 就是发生了。
有频繁GC的事件发生的时候,也要注意下,可能是在 OOM的边缘疯狂试探。 比如 FullGC, Young GC,等。
CPU占用率较高。
先说一个思路哈~
止损。
如果你在线上遇到了这个问题, 请,务必! 先将服务重启!立刻,马上。 及时止损。 ps: 可以留一台机器做案发现场,记得下掉该机器,不对外提供服务。
问题排查
注意观察线上服务情况,如果再次出现OOM, 影响业务,再问题没有解决完成之前,还是采用重启的方式解决。
可以通过 glowroot等可视化的监控工具,观察。
也可以通过在机器上 使用 jstat -gc pid 来查看GC情况。
分析造成OOM的问题。(具体如何排查,可参考案例模块)
查到对应JVM进程 => 排查到占用内存打的jvm线程 => 查看对应线程栈信息 => 使用Jmap来生成线程堆栈信息文件 => 分析大对象or占用内存大的原因 => 基本上改代码或者jvm配置。
其他排查问题思路和这个也是大差不差,使用的命令不同而已。
案例
+++warning 举个栗子🌰吧
比较常见的应该是: java.lang. outOfMemoryError: Java heap Space
/**
 * 演示OOM 排查过程
 */
private static void heapSpaceError() {
    Thread thread = new Thread(() -> bigObject());
    thread.start();
}

/**
 * 演示大对象
 * -Xms128M -Xmx128M
 */
public static void bigObject() {
    // 21 可以,22就会OOM
    // 4* 1024 * 1024 = 4M * 32 = 128M
    int[] integers = new int[1024 * 1024 * 22];
}执行后发现控制台打印出了OOM : java heap space. 好吧,就装作看不见吧
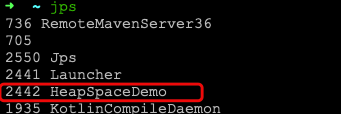
1、使用 jps 命令获取到 jvm进程号
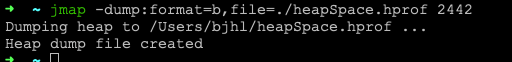
2、使用 jmap命令dump出 堆栈信息。
3、使用 mat 工具,分析dump文件内容。 (下载地址: https://www.eclipse.org/mat/downloads.php 下载是真特🐴的慢啊,[:heart:一般人我不告诉他:公众号回复MAT就能直接获取]{.label .success})
如果下载之后无法启动的话,提示 无法创建虚拟机。需要简单配置下:
-vm /Library/Java/JavaVirtualMachines/jdk1.8.0_251.jdk/Contents/Home/bin
3.1、下载下dump文件,使用本地分析mat工具进行分析。
启动mat.
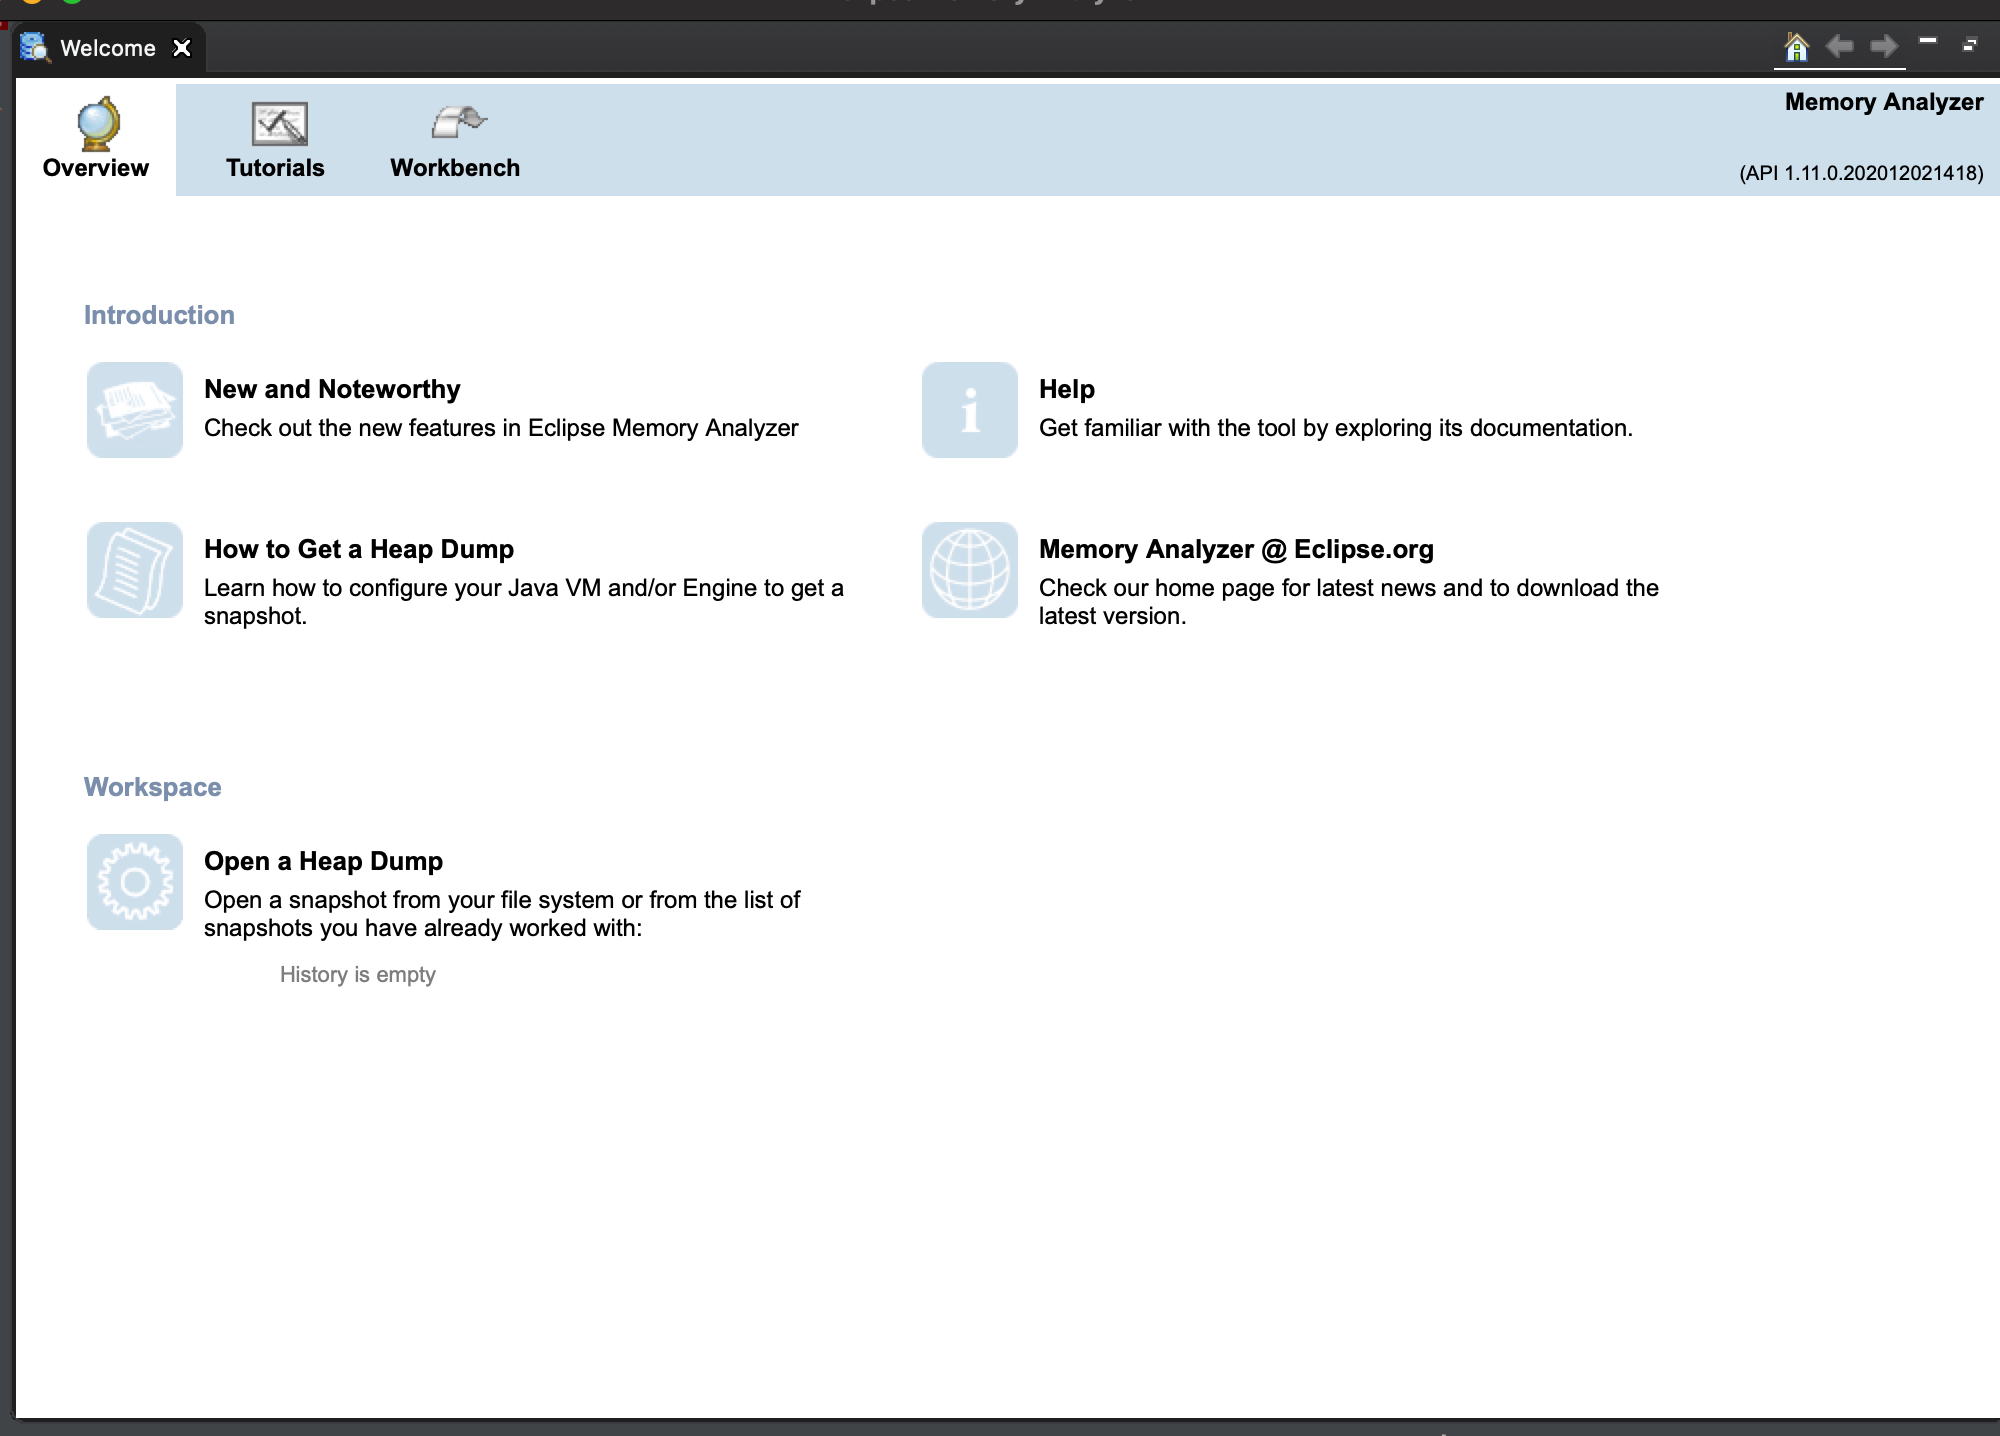
Open a heap Dump 之后,就可以愉快的分析了。
具体分析方法请自行百度吧。
3.2、如果dump文件较小,也可以java自带的工具 jhat命令进行分析。
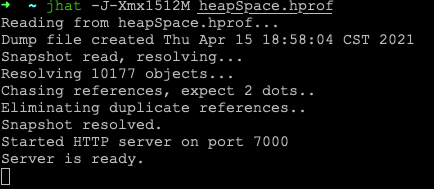
然后访问本机的 7000端口,就可以到看到分析的内容了。
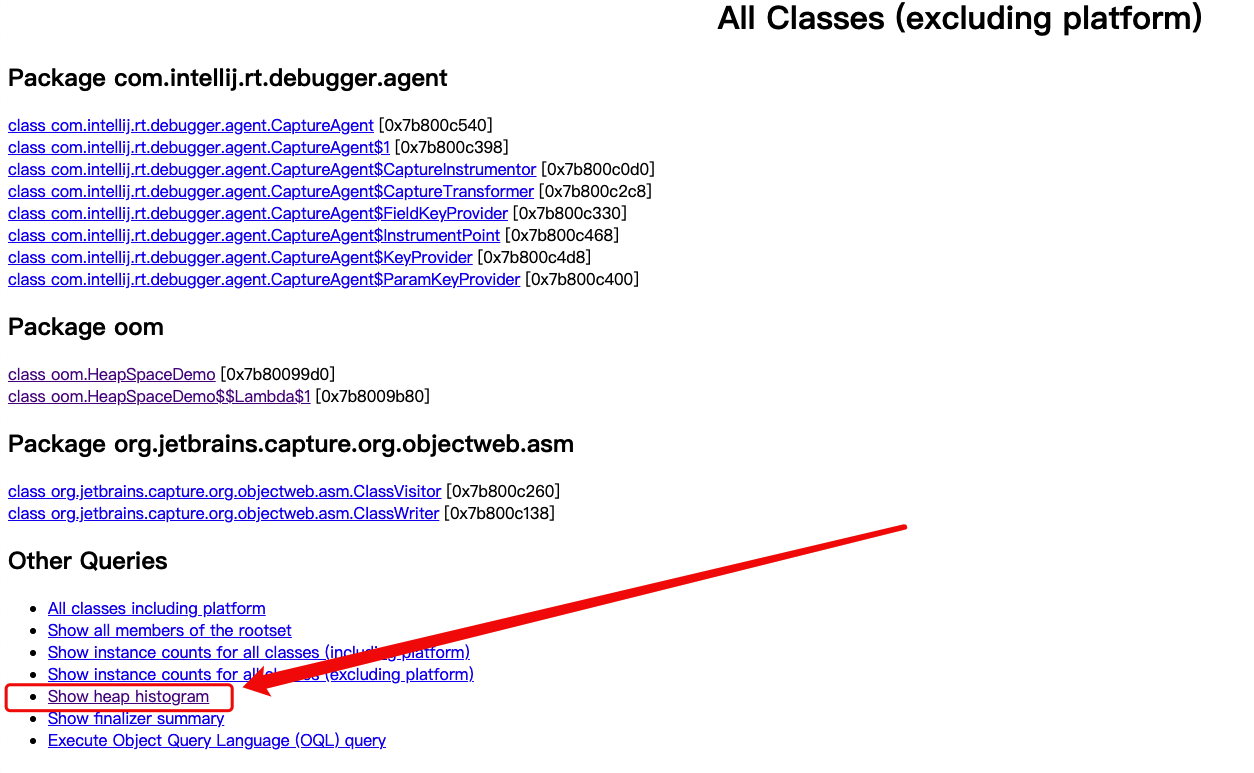 进入之后,就可以看到堆内存占用情况的柱状图了。
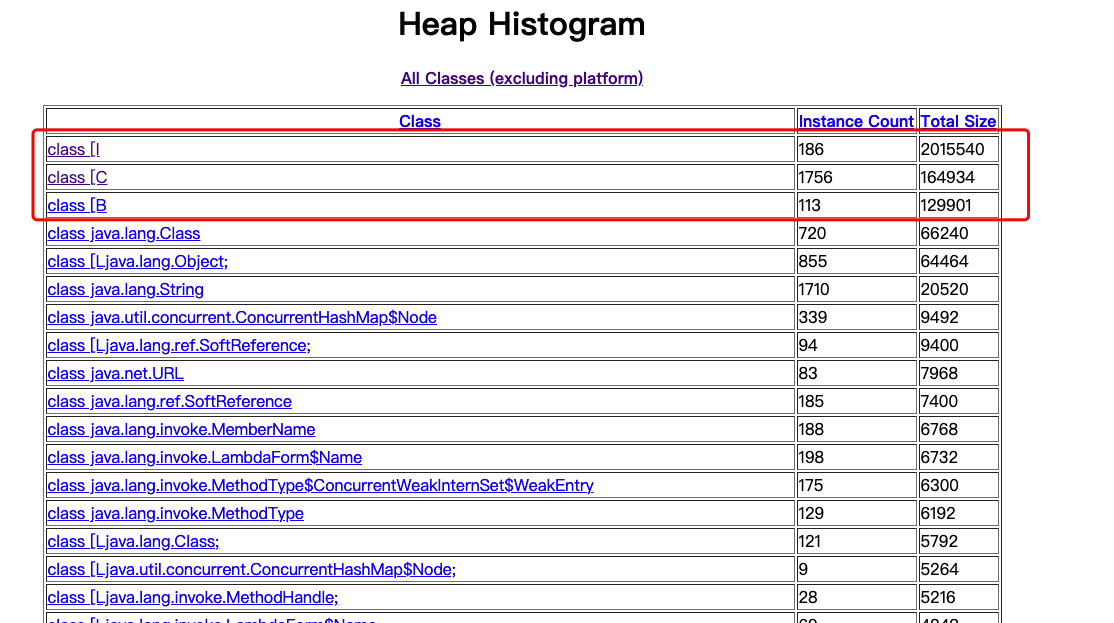 发现有
Class[I占用最多, Class[I 表示的是 int 数组。 那我们就查下代码里用到Class[I 中的地方,
哇,果然是在 new 了一个大的数据,撑爆了内存。
补充下:
先查看jvm进程号
jps 注意: 只能查看属于当前用户java进程
ps -ef| grep java 找到对应服务的进程编号
ps -ef| grep 服务名
如下图:
 需要注意下:
1)查看当前应用运行情况信息,查看是否配置了gc log:-Xloggc:/apps/srv/instance/damai.gaotu100.com/logs/damai.gaotu100.com-gc.log , 可以从gc 日志中查到很多信息。
2)查看是否有oom自动打印二进制dump文件: -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/apps/srv/instance/damai.gaotu100.com/logs/heapdump.hprof 。
如果没有配置,可以通过命令自行打印:
jmap -dump:format=b,file=/apps/srv/instance/test-kefu-web.baijiahulian.com/logs/22316.1.hprof pid
这里推荐下,阿里开源的jvm排查工具 arthas(阿尔萨斯) https://arthas.aliyun.com/doc/。文档很全,需要的自行阅读吧~~
+++
解决方案
分享遇到OOM问题时怎样解决?
长兄于病视神,未有形而除之,故名不出于家。中兄治病,其在毫毛,故名不出于闾。若扁鹊者,镵血脉,投毒药,副肌肤,闲而名出闻于诸侯。 所以才有凡此者不病病,治之无名,使之无形,至功之成,其下谓之自然。 这句话,用在我们这里就是 系统的整个生命周期中,不出现任何
OOM, 其 谓之自然。
根据上述的排查过程,找到了问题根源之后,那就 1.改代码 2.调整内存配置
大刀阔斧的干吧!
:::success no-icon 大家有什么建议呢? :::
总结
我们看待OOM 应该从全面来看,有可能是 jvm内存确实盛不下要分配的对象,也有可能是 频繁GC,且收效甚低导致的,还有可能是宿主机上内存不够杀死jvm导致的,加载的类过大过多造成的,虚拟内存不够用等等。最后也不要忽略 堆外内存的内存溢出。
线上遇到这类问题,第一要及时止损,方式很简单,重启就能解决。 保证线上可用之后,再去查问题,根治问题。 同时不用忘了监控线上服务是否有内存要溢出的情况,及时重启,为处理OOM问题争取时间。
排查问题时,首先找到对应jvm进程,然后使用jmap打印出 内存映射文件,然后使用jhat 或者 mat 工具进行分析,定位原因。解决问题。
最后,我们在coding的时候,要注意下,不要编写导致OOM代码。“未有形而除之~”
抛个问题~
发生OOM,程序会退出吗?
下期见
最后
希望和你一起遇见更好的自己